
سرورهای HPE برای فعالیت مداوم در زیرساختهای سازمانی طراحی شدهاند؛ اما این موضوع به معنای مصون بودن آنها از اختلالات سختافزاری و نرمافزاری نیست. یکی از مشکلاتی که ممکن است مدیران شبکه با آن مواجه شوند، ریستارت شدن ناگهانی سرور HPE است. این اتفاق گاهی فقط یک بار رخ میدهد، اما در برخی شرایط بهصورت مکرر تکرار میشود و میتواند دسترسی کاربران به سرویسها، عملکرد نرمافزارهای سازمانی و حتی یکپارچگی دادهها را تحت تأثیر قرار دهد.
برای رفع این مشکل، ابتدا باید مشخص شود که سرور به دلیل اختلال سختافزاری، افزایش دما، نوسان برق یا خطاهای نرمافزاری Restart شده است. در این مقاله، مهمترین دلایل ریستارت ناگهانی سرورهای HPE و روشهای شناسایی و عیبیابی آنها را بررسی میکنیم.
مهمترین دلایل ریستارت شدن سرور HPE
ریستارت ناگهانی سرور میتواند دلایل مختلفی داشته باشد. گاهی یک قطعه سختافزاری معیوب باعث خاموشی و راهاندازی مجدد سیستم میشود و گاهی تنظیمات نادرست یا خطاهای سیستمعامل چنین مشکلی ایجاد میکنند.
۱. افزایش بیش از حد دمای سرور
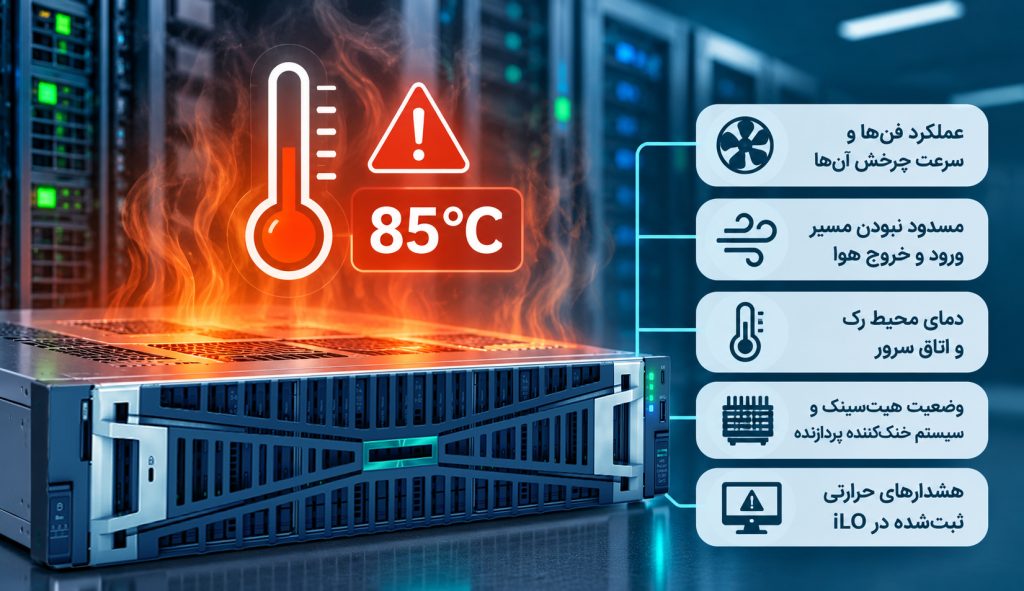
یکی از دلایل احتمالی ریستارت شدن سرور HPE، افزایش دمای پردازنده یا سایر قطعات داخلی است. پردازندهها، ماژولهای حافظه و کنترلرهای ذخیرهسازی هنگام فعالیت گرما تولید میکنند. اگر سیستم خنککننده نتواند این گرما را بهدرستی دفع کند، دمای قطعات از محدوده مجاز فراتر میرود.
در چنین شرایطی، مکانیزمهای حفاظتی سرور ممکن است برای جلوگیری از آسیب سختافزاری، عملکرد سیستم را محدود یا آن را خاموش کنند.
مواردی که باید بررسی شوند:
- عملکرد فنها و سرعت چرخش آنها
- مسدود نبودن مسیر ورود و خروج هوا
- دمای محیط رک و اتاق سرور
- وضعیت هیتسینک و سیستم خنککننده پردازنده
- هشدارهای حرارتی ثبتشده در iLO
۲. اختلال در منبع تغذیه (Power Supply)
منبع تغذیه وظیفه تأمین برق پایدار برای قطعات مختلف سرور را بر عهده دارد. خرابی پاور، نوسان ولتاژ ورودی یا اختلال در سیستم توزیع برق رک میتواند باعث خاموش شدن یا Restart ناگهانی سرور شود.
در سرورهایی که از دو منبع تغذیه Redundant استفاده میکنند، خرابی یکی از پاورها لزوماً به معنی خاموشی سیستم نیست؛ اما اگر پاور دوم نیز دچار مشکل شود یا ظرفیت آن برای تأمین بار کافی نباشد، احتمال قطعی وجود دارد.
برای عیبیابی، وضعیت هر دو پاور، کابلهای برق، PDU و هشدارهای مربوط به منبع تغذیه را بررسی کنید.
۳. خرابی حافظه RAM
ماژولهای RAM نقش مهمی در پردازش اطلاعات دارند. بروز خطاهای حافظه میتواند باعث ناپایداری سیستم، توقف پردازشها یا در برخی شرایط ریستارت شدن سرور HPE شود.
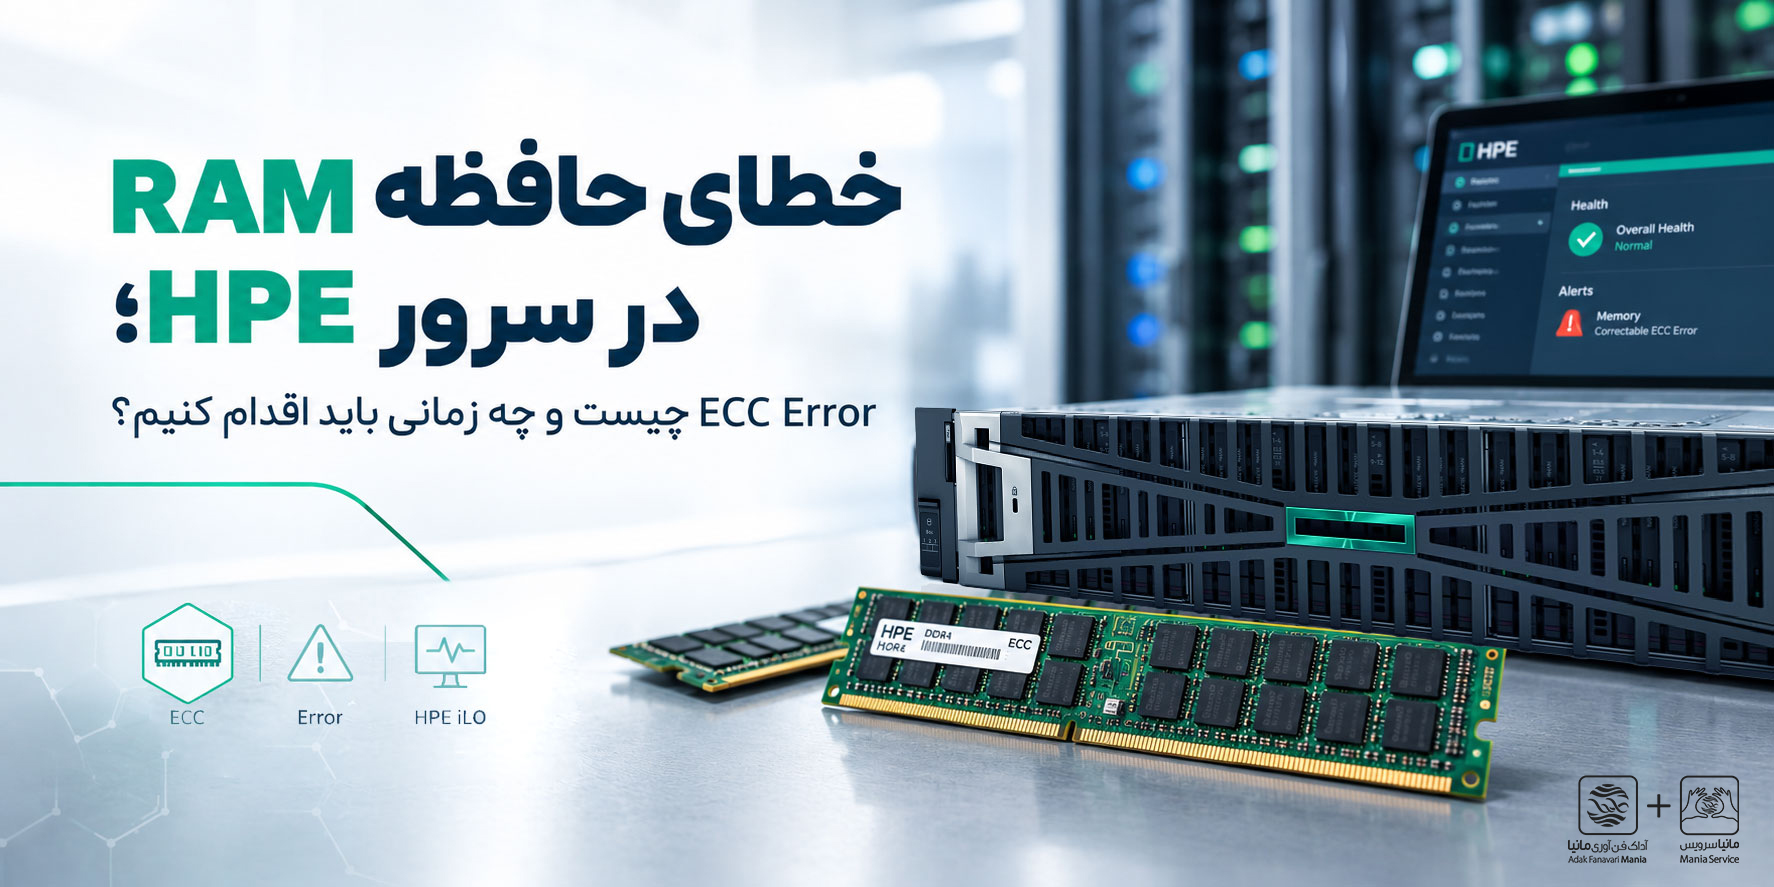
در سرورهای HPE، کنترل خطاهای حافظه از طریق قابلیتهایی مانند ECC انجام میشود. این فناوری میتواند برخی خطاهای حافظه را شناسایی و اصلاح کند؛ اما افزایش خطاهای اصلاحشده یا مشاهده خطاهای اصلاحنشده (Uncorrectable Errors) ممکن است نشانه وجود مشکل در DIMM یا مسیر حافظه باشد.
برای بررسی این وضعیت، گزارشهای Integrated Management Log و ابزارهای تشخیصی HPE را بررسی کنید.
۴. مشکلات BIOS و Firmware
قدیمی بودن BIOS یا Firmware قطعات مختلف سرور ممکن است باعث ناسازگاری، اختلال در عملکرد سختافزار یا بروز خطاهای سیستمی شود.
Firmware کنترلر RAID، کارت شبکه، کنترلر ذخیرهسازی و سایر قطعات نیز در پایداری سرور نقش دارند. در بعضی شرایط، بهروزرسانی ناقص یا ناسازگار Firmware میتواند مشکلاتی مانند Restart ناخواسته ایجاد کند.
پیش از بهروزرسانی، نسخه فعلی Firmware را بررسی کرده و از سازگاری نسخه جدید با مدل سرور و سایر قطعات اطمینان حاصل کنید. همچنین بهتر است بهروزرسانی در بازه نگهداری و با داشتن نسخه پشتیبان از تنظیمات انجام شود.
۵. خطاهای سیستمعامل و درایورها
همیشه دلیل ریستارت ناگهانی سرور یک مشکل سختافزاری نیست. گاهی خطاهای Kernel، ناسازگاری درایورها، بهروزرسانی ناموفق سیستمعامل یا مشکلات نرمافزاری باعث توقف سیستم میشوند.
برای مثال، در محیط ویندوز سرور ممکن است خطای Blue Screen of Death (BSOD) باعث راهاندازی مجدد خودکار شود. در سیستمعامل لینوکس نیز Kernel Panic میتواند عملکرد سیستم را متوقف کند.
بررسی System Logs، Event Viewer در ویندوز و لاگهای سیستمی در لینوکس میتواند به شناسایی منشأ مشکل کمک کند.
۶. فشار پردازشی بیش از حد و مشکلات منابع
اجرای همزمان ماشینهای مجازی، پردازشهای سنگین یا سرویسهای متعدد ممکن است منابع سرور را تحت فشار قرار دهد. اگرچه مصرف بالای CPU یا RAM بهتنهایی معمولاً باعث Restart نمیشود، اما میتواند در کنار مشکلاتی مانند ناپایداری نرمافزار، خطاهای حافظه یا اختلالات حرارتی، زمینه بروز مشکل را فراهم کند.
به همین دلیل، بررسی میزان مصرف منابع، بار پردازشی و وضعیت ماشینهای مجازی در زمان وقوع حادثه اهمیت دارد.
چگونه علت ریستارت ناگهانی سرور HPE را پیدا کنیم؟
برای عیبیابی دقیق، بهتر است بررسیها بهصورت مرحلهای انجام شوند. یکی از مهمترین ابزارها در سرورهای HPE، فناوری مدیریتی iLO است.
iLO امکان مدیریت و پایش وضعیت سختافزار سرور را فراهم میکند و در بسیاری از مدلها حتی زمانی که سیستمعامل در دسترس نیست، میتوان از طریق آن اطلاعات مدیریتی و هشدارها را مشاهده کرد.
برای پیدا کردن علت Restart، مراحل زیر را دنبال کنید:
- بررسی Integrated Management Log (IML): خطاها و هشدارهای مربوط به دما، حافظه، پاور و سایر قطعات را بررسی کنید.
- بررسی Integrated Remote Console و وضعیت iLO: در صورت وجود اطلاعات مربوط به آخرین راهاندازی مجدد یا خطاهای ثبتشده، آنها را تحلیل کنید.
- بررسی گزارشهای سیستمعامل: زمان وقوع Restart را با خطاهای ثبتشده در Event Viewer یا لاگهای لینوکس تطبیق دهید.
- بررسی وضعیت سختافزار: سلامت پاورها، فنها، RAM، پردازنده و کنترلر ذخیرهسازی را ارزیابی کنید.
- اجرای تستهای تشخیصی: در صورت مشاهده خطاهای سختافزاری، از ابزارهای تشخیصی سازگار با مدل سرور استفاده کنید.
نکته مهم این است که ثبت رویدادهایی مانند قطع ناگهانی برق یا Hard Reset ممکن است فقط نوع خاموشی را مشخص کند، نه علت اصلی آن را. بنابراین باید اطلاعات iLO، لاگ سیستمعامل و وضعیت تجهیزات برق بهصورت همزمان بررسی شوند.
چگونه از ریستارتهای مکرر سرور جلوگیری کنیم؟
پس از شناسایی علت اصلی، میتوان با انجام اقدامات پیشگیرانه احتمال تکرار مشکل را کاهش داد:
- دمای اتاق سرور و وضعیت تهویه را بهصورت منظم پایش کنید.
- سلامت پاورها و تجهیزات توزیع برق را بررسی کنید.
- از UPS مناسب و متناسب با توان مصرفی زیرساخت استفاده کنید.
- Firmware و درایورها را مطابق توصیههای سازنده بهروزرسانی کنید.
- گزارشهای iLO و IML را بهصورت دورهای بررسی کنید.
- سلامت حافظه و سایر قطعات سختافزاری را در برنامه نگهداری قرار دهید.
- برای سیستمعامل و نرمافزارهای سرور، بهروزرسانیهای پایدار و سازگار نصب کنید.
جمعبندی
ریستارت شدن سرور HPE میتواند ناشی از مشکلاتی مانند افزایش دما، خرابی منبع تغذیه، خطاهای حافظه، ناسازگاری Firmware یا اختلالات سیستمعامل باشد. برای رفع اصولی این مشکل، نباید صرفاً به راهاندازی مجدد سرور یا تعویض قطعات اکتفا کرد؛ بلکه لازم است گزارشهای سختافزاری و نرمافزاری بررسی شوند تا علت اصلی مشخص شود.
پایش مداوم وضعیت سرور، استفاده از قابلیتهای مدیریتی iLO و اجرای برنامه نگهداری پیشگیرانه میتواند از بروز بسیاری از اختلالات و توقف ناخواسته سرویسهای سازمانی جلوگیری کند.
سؤالات متداول
آیا ریستارت شدن ناگهانی سرور HPE همیشه نشانه خرابی سختافزار است؟
خیر. مشکلات سیستمعامل، درایورها، Firmware و حتی اختلالات برق نیز میتوانند باعث Restart ناگهانی شوند.
آیا iLO میتواند علت ریستارت سرور را مشخص کند؟
iLO با ثبت اطلاعات مدیریتی، هشدارهای سختافزاری و رویدادهای سیستمی به عیبیابی کمک میکند؛ اما برای تشخیص قطعی علت، ممکن است بررسی لاگ سیستمعامل و تجهیزات برق نیز لازم باشد.
آیا افزایش دمای سرور باعث خاموش شدن خودکار آن میشود؟
بله. در صورت عبور دما از آستانههای حفاظتی، سرور ممکن است برای جلوگیری از آسیب سختافزاری عملکرد خود را محدود یا سیستم را خاموش کند.
برای جلوگیری از ریستارت مکرر سرور HPE چه باید کرد؟
پایش دما، بررسی پاورها، کنترل سلامت RAM، بهروزرسانی اصولی Firmware و بررسی منظم گزارشهای iLO از مهمترین اقدامات پیشگیرانه هستند.
برای پایداری سرورهای HPE، عیبیابی را جدی بگیرید
ریستارتهای ناگهانی سرور میتوانند نشانهای از وجود مشکلات سختافزاری یا نرمافزاری باشند و تداوم آنها عملکرد سرویسهای سازمانی را مختل کند. اگر سرور HPE شما با خاموشی یا Restart مکرر مواجه شده است، بهتر است پیش از بروز اختلالات جدیتر، وضعیت سختافزار و زیرساخت آن را بهصورت تخصصی بررسی کنید.
برای دریافت مشاوره با شماره 021-43672 تماس بگیرید.